証拠の種類:算法模拟,不是目标软件实测。 記載された条件でのみ結論が成立します。
問い
100万件の名前から特定のファイルを探すには、先頭から一つずつ確認する必要があるのでしょうか。それとも、事前に作成した索引を使えば素早く探せるのでしょうか。
方法
Python で 1,000・10,000・100,000・1,000,000 件の一意な仮想ファイル名を作成しました。順次探索と、あらかじめファイル名から位置への辞書を構築する方法を比較しました。各規模で固定シード 20261119 を使い20のランダムな対象位置を選び、先頭・末尾・該当なしのケースを追加しました。各条件を5回計測し、両方式が同じ正しい位置を返すことを確認しました。ファイルはディスク上ではなくメモリ内に存在します。
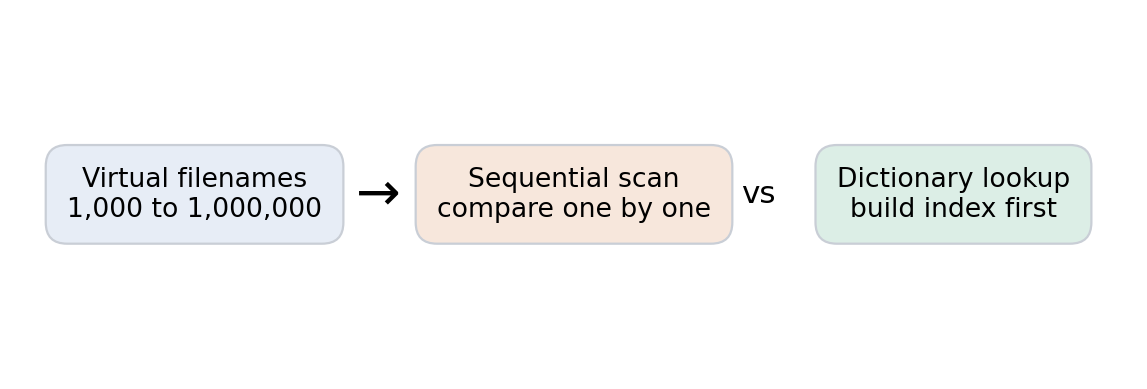 図1|方法の模式図。測定結果ではありません。
結果
| ファイル名数 | 順次探索(ms) | 辞書検索(ms/回) |
|---|---|---|
| 1,000 | 0.0155 | 0.000050 |
| 10,000 | 0.1235 | 0.000053 |
| 100,000 | 1.5573 | 0.000054 |
| 1,000,000 | 21.1757 | 0.000057 |
20のランダムな対象位置について、各位置の5回計測の中央値から再び中央値を求めました。辞書検索は1,000回の一括計測を1回あたりに換算しており、計時方式が異なるため正確な速度倍率として解釈できません。
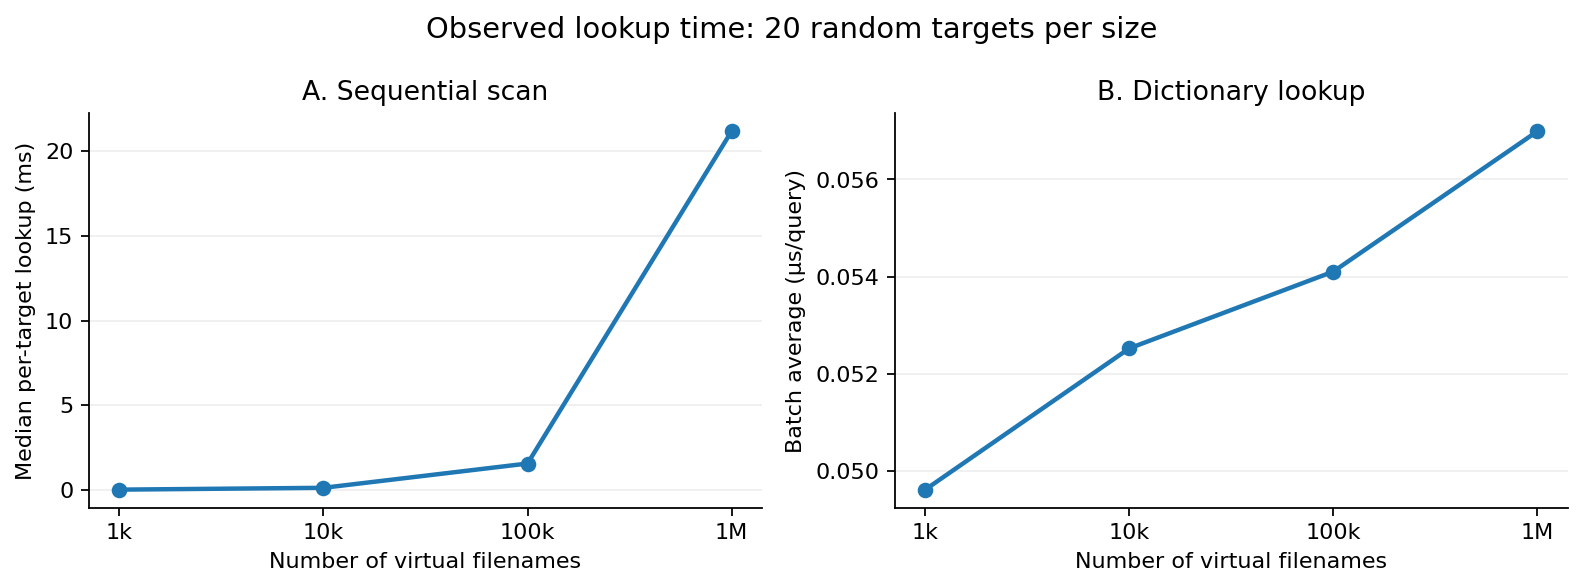 図2|実行したPythonプログラムの計測値。縦軸の尺度が異なります。
先頭にある名前は順次探索でもすぐに見つかります。一方、対象が後方にある場合や存在しない場合、比較回数が増えます。
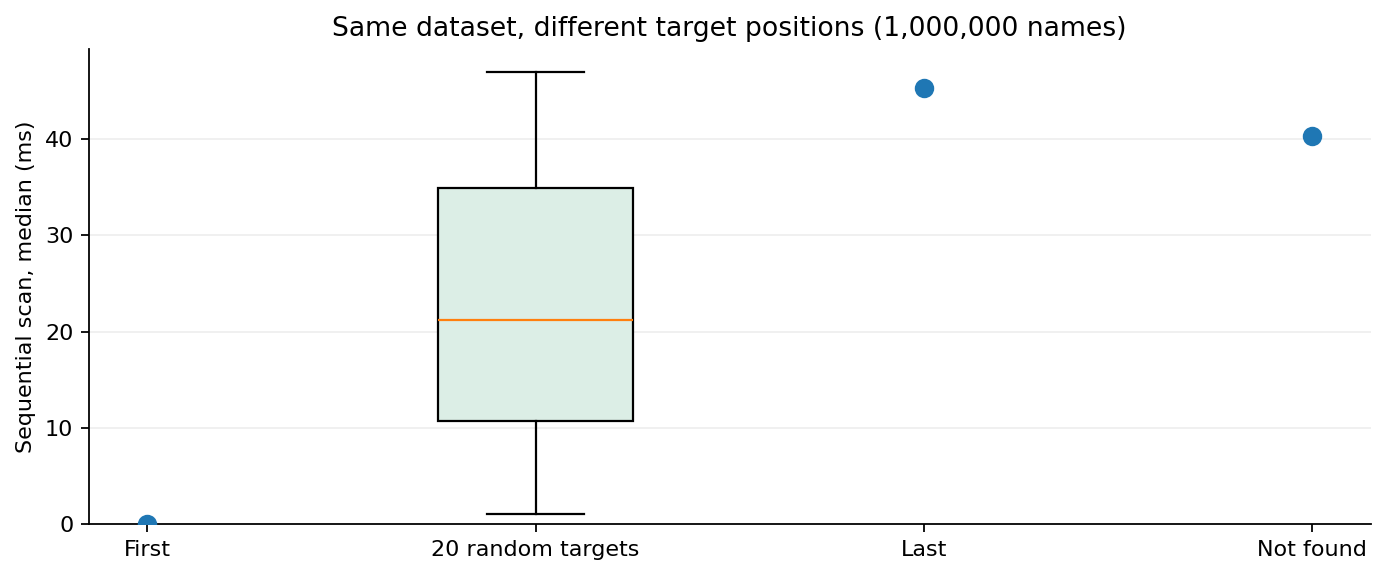 図3|探索対象の位置が順次探索に与える影響。
索引には構築コストもあります。今回の一度だけの計測では、4つの規模で順に 0.17、2.66、44.80、320.27 ms かかりました。安定した平均値とはみなせません。
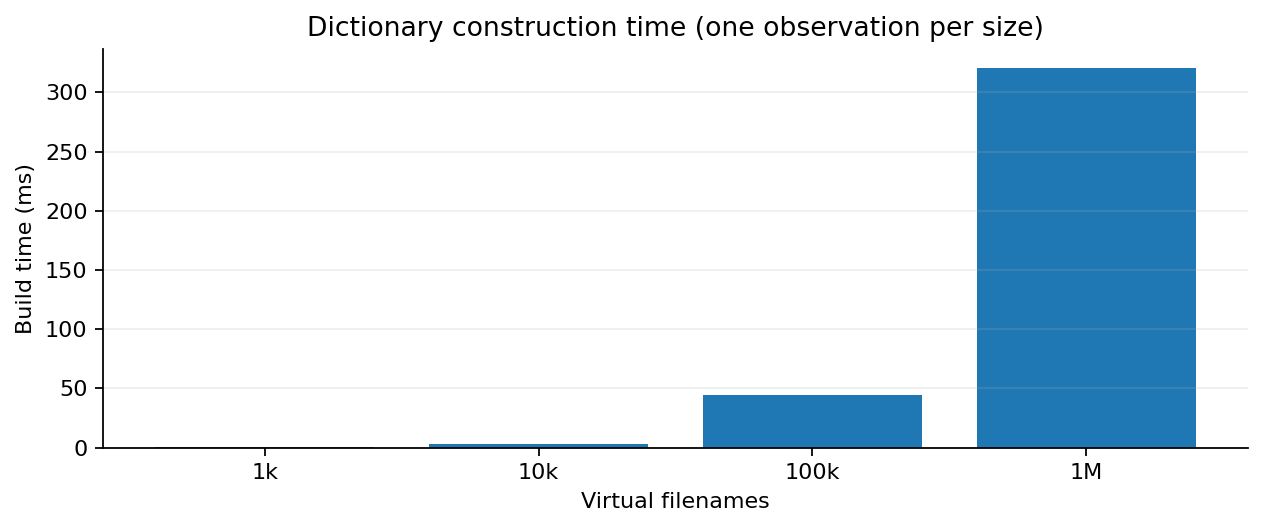 図4|各データ規模で索引を構築する時間。一回のみの観測。
結論と限界
今回のメモリ内での完全一致検索では、辞書索引を事前に構築することで、その後の検索時間を小さく保てました。ただし索引構築には時間がかかり、順次探索は対象位置によって速度が変わります。Everything は NTFS の情報や変更履歴を利用しますが、Python の辞書と同じ実装ではありません。Windows Search も索引を利用します。このシミュレーションから両ソフトの性能順位は導けません。
ソースコード、計測値、実行環境の記録を添付しました。AI はプログラム作成と原稿整理を支援しました。独立した第三者による再現はまだ確認していません。