实验类型:算法模拟,不是目标软件实测。 本文结论仅适用于所述测试条件。
ZIRULAB 小实验 #001 · 2026 年 11 月 19 日 · 计算机模拟 / 原理验证
先说结果: 在本次实际执行的 Python 模拟中,文件名越多,逐个查找通常越慢;提前建好字典索引后,完整文件名的查找时间变化较小。但建立索引也有成本。这是关于算法原理的实验,不是 Everything 或 Windows Search 的真实跑分。
摘要
为什么 Everything 搜索文件名时常常给人“瞬间出现”的感觉?我们用 Python 构造 1,000 至 100 万个虚拟文件名,比较“从头逐个寻找”和“先建立字典索引再查找”两种方法。每种规模随机抽取 20 个目标,另设首位、末位和找不到的情况,每个目标重复 5 次。所有返回结果均通过正确性检查。100 万条时,随机目标的顺序查找中位数为 21.1757 ms,字典查找的批量平均计时中位数为 0.000057 ms。由于计时方式不同,两者不用于给出精确的加速倍数。实验支持“预先索引可以降低反复精确查找的成本”,但并不等价于对实际 Everything 软件性能的测量。
1. 问题:找文件,必须一个个翻吗?
想象一张写着 100 万个文件名的清单。要找其中一个文件,可以从第一行一直往下看;也可以事先制作一份“名字—位置”目录。第二种办法需要先花时间做目录,但以后每次查询可能都更省事。
Everything 官方介绍了它利用 NTFS 文件系统信息建立文件名索引、并通过 USN 变更日志跟踪变化的机制。我们的疑问是:如果只研究“是否事先建立索引”这个因素,查找时间会怎样变化?
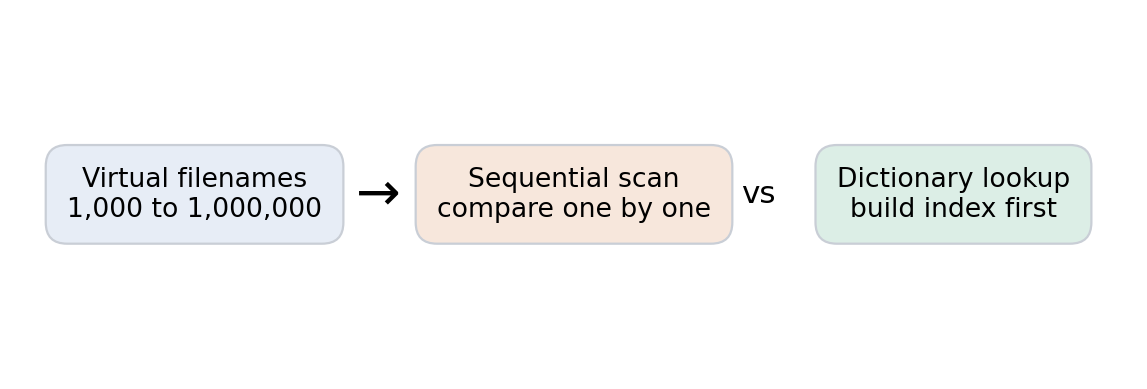 figure1_design.png
图 1|本实验只比较内存中的两种简化算法。实际 Everything 不等于 Python 字典。
2. 方法:让程序自己给出结果
数据。 Python 自动生成 1,000、10,000、100,000、1,000,000 个互不重复的虚拟文件名,例如 FILE_0000001_ZL.txt。它们仅存在于内存里,没有在硬盘上创建任何文件。
两种方法。 A 是线性扫描:从第一项开始逐个比较,匹配后返回位置。B 是字典索引:预先建立 文件名 → 位置 的映射,再进行完整名称的精确查找。两者都查询同一批数据,并返回同一位置或“未找到”。
怎样避免只挑好看的结果? 每种数据规模由固定随机种子 20261119 产生 20 个目标位置,再额外测试列表第一项、最后一项和不存在的名字。每个目标每种方法各测 5 次,交替执行顺序。固定种子只负责让他人抽到同样的位置,不负责预设结果。两种方法返回位置错误或不一致时程序会报错停止。
怎么计时? 用 Python perf_counter_ns()。线性扫描每次单独计时;非常短的字典查询则连续执行 1,000 次,再取每次的平均耗时(包括 Python 循环和结果核对开销)。对每个目标先取 5 次计时的中位数,再对 20 个随机目标取中位数。因为测量方式不同,我们不把这两列计算成“快了多少倍”。
3. 结果:索引的优势出现在重复查找中
| 虚拟文件名数 | 线性扫描(ms) | 字典查找(ms/次) |
|---|---|---|
| 1,000 | 0.0155 | 0.000050 |
| 10,000 | 0.1235 | 0.000053 |
| 100,000 | 1.5573 | 0.000054 |
| 1,000,000 | 21.1757 | 0.000057 |
表 1|20 个随机目标的“每目标五次中位数”的总体中位数。字典值是批量计时除以次数所得,不能视为纯粹、独立的单次字典操作时间。毫秒数仅对应本次运行环境。
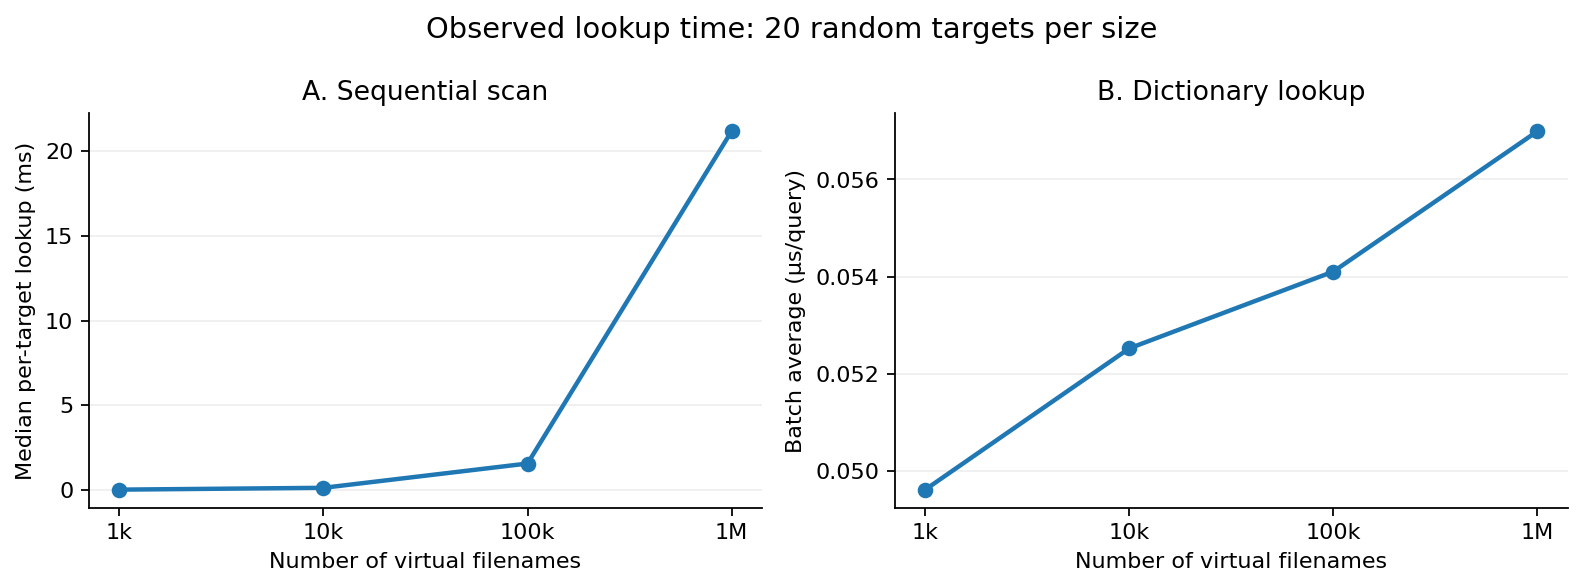 figure2_lookup_results.png
图 2|左右分图采用不同纵轴单位,目的是分别展示趋势,而不是暗示精确倍数。所有点均由本次运行的 CSV 计算。
发现①: 数据规模从 1,000 增至 100 万时,顺序查找的耗时增加明显;字典精确查找的批量平均耗时依然处在较低水平。这符合两种实现的预期工作量差异,但绝对时间也受运行环境影响。
发现②: 逐个查找不一定慢。目标恰好是第一项时,扫描很快;目标在后面或根本不存在时,要检查的名字更多。这也是为什么只测试“最后一个文件”并不公平。
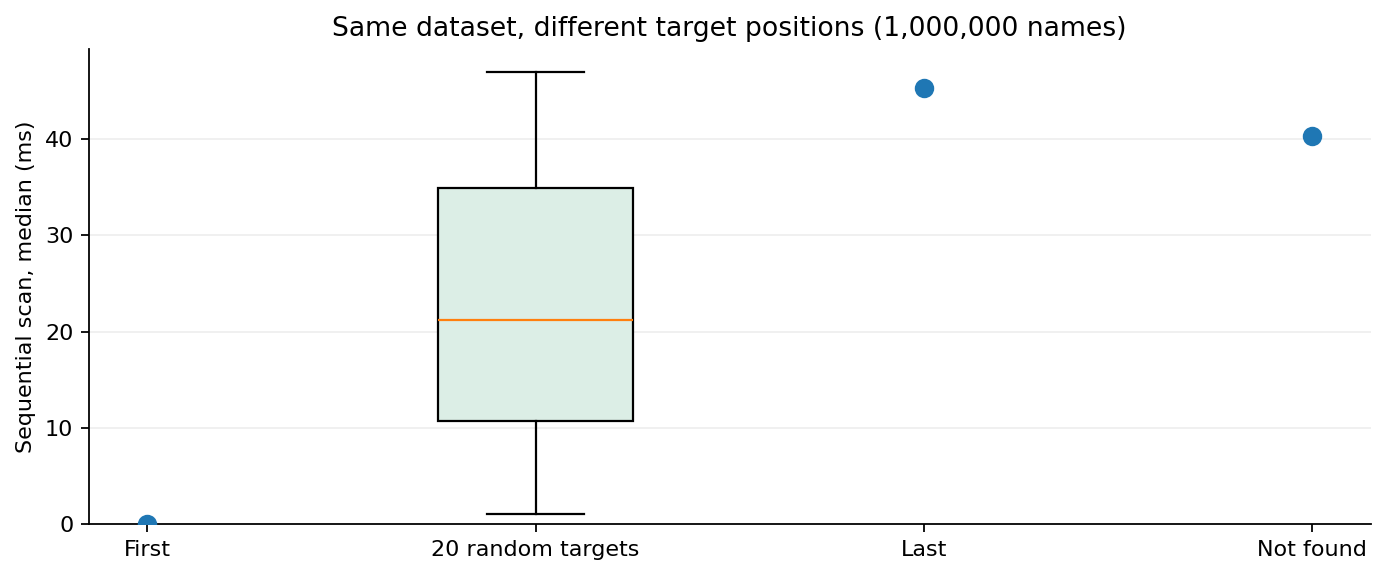 figure3_position_effect.png
图 3|随机样本箱线图与首位、末位、缺失目标的实际计时。这里只展示线性扫描,不能推断真实 Windows 搜索的表现。
发现③:索引不是免费的。 本次只测量了一次建立字典所需的时间,分别为 0.17、2.66、44.80、320.27 ms(依次对应四个规模)。这些是单次观察值,不能当作稳定平均性能,也不能据此给出可靠的“搜索几次一定回本”阈值。
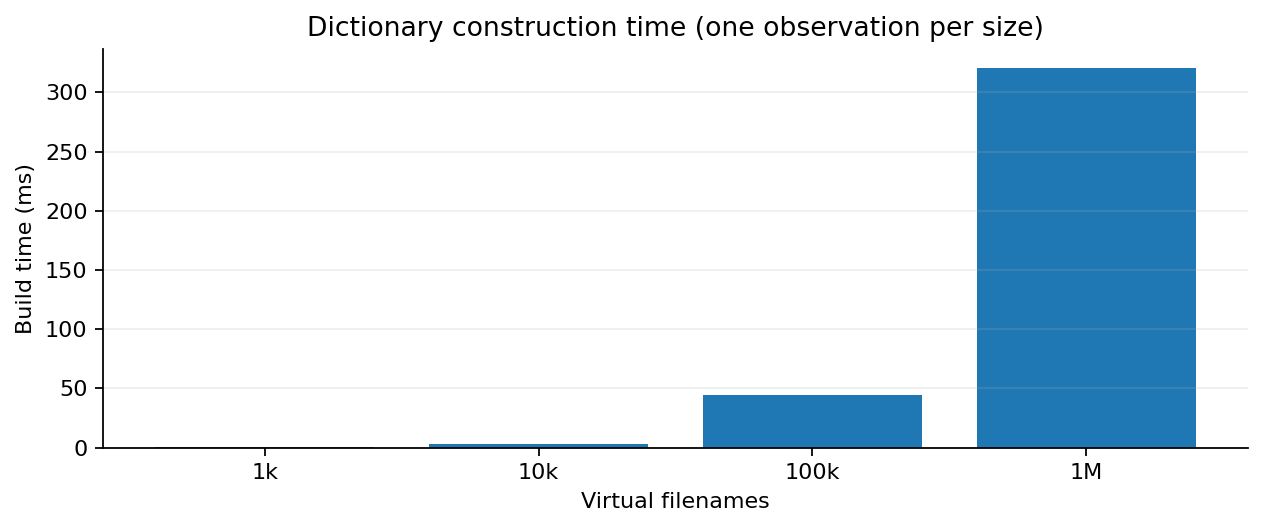 figure4_build_cost.png
图 4|每组只有一次观测,主要说明建索引存在成本,不用于精密性能推断。
4. 这能解释 Everything,但不能替它“跑分”
实验说明了一个简单道理:搜索看起来快,可能因为大量整理工作早已完成。 这与 Everything 的文件名索引理念有关。但 Everything 的真实索引结构、部分名称匹配、更新机制、磁盘行为和系统集成远比这个 Python 模型复杂。Windows Search 也使用索引,绝不能把本实验的线性扫描称为“Windows 搜索”。
这次既没运行 Everything,也没运行 Windows Search;没有创建百万个真实文件,没比较模糊匹配、全文搜索、NAS 或索引更新。因此,“Everything 比 Windows 快多少倍”不是本实验能够回答的问题。
5. 结论
在内存、完整文件名精确匹配这一明确范围内,真实执行的计算结果支持:
- 线性查找的耗时受数据规模和目标位置影响;
- 预建字典索引能使后续精确查找在测试规模中保持很低的耗时;
- 索引建立本身有不可忽略的成本;
- 上述结果不能直接外推为任何真实 Windows 搜索软件的速度排名。
如果只记住一句话:快速搜索背后,往往是提前做好的“目录”。
6. 实验透明度与复现
- 实际执行环境: Linux x86-64、Python 3.13.5;计时函数
perf_counter_ns()。 - 实验规模: 4 组数据 ×(20 个随机目标 + 首位 + 末位 + 缺失)× 2 种方法 × 5 次重复 = 920 条计时记录。
- 正确性: 代码逐次核对查找位置,920 次记录来自完成检查的查询计时;这是内部程序检查,不是独立第三方审计。
- 材料: 源码
benchmark_final.py、raw_measurements.csv、case_summary.csv、build_times.csv、methods_results.json,以及所有配图。 - 复现命令:
python benchmark_final.py(Python 3.9+;无需第三方 Python 库)。会生成新的计时记录;不同机器的具体耗时无需与本文相同。 - 局限: 字典与扫描采用不同计时协议;索引构建仅测一次;只测内存中的完整名称精确匹配;未测真实软件、磁盘 I/O、资源占用和更新成本。随机样本规模有限,未进行统计推断。
- AI 参与说明: AI 协助编写程序、生成图表和整理文字;数据是实际执行程序所得,未由 AI 直接编造或预设。
参考资料
ZIRULAB · Mini Experiment 001 · 文章类型:计算机模拟 / 原理验证。